Un RAG sin nube ni llave de API: anatomía de un montaje mínimo
Los seis componentes de un sistema de generación aumentada por recuperación sobre un corpus de 10 KB: función de cada uno, tiempos medidos por etapa y limitaciones observadas.
Un gran modelo de lenguaje (LLM, large language model) [b] responde a partir de su corpus de entrenamiento y de nada más. Si el documento consultado no está en ese corpus, el modelo responde que no lo conoce o alucina: genera una respuesta falsa.
La generación aumentada por recuperación (RAG, retrieval-augmented generation) extiende lo que el modelo puede responder más allá de su corpus de entrenamiento y reduce la alucinación: antes de responder, el sistema busca los fragmentos pertinentes en un conjunto de documentos y los entrega al modelo junto con la pregunta. La propusieron Lewis y colaboradores en 2020 [1].
Un RAG se puede montar sobre un servicio en la nube, que requiere una llave de API (la credencial con la que el proveedor autoriza y cobra cada consulta), y una biblioteca que resuelve todos los pasos en una sola llamada. Esa vía sirve para construir rápido, no para entender: los pasos quedan ocultos tras esa llamada.
Este montaje implementa desde cero una versión mínima y extremadamente básica de un RAG, que corre en la máquina local y a costo cero. De ninguna manera pretende reemplazar a una implementación formal: se creó con fines didácticos. El código es público, bajo licencia MIT [10].
Definir a detalle la técnica no es el objeto de este artículo. El trabajo de Lewis y colaboradores [1] y el artículo de Wikipedia sobre el tema [12] ya lo hacen, y con más detalle del que cabe aquí. Lo que sí es necesario abordar para entender una implementación es que un RAG es un proceso de seis componentes y dos fases.
Seis componentes y dos fases
Un RAG tiene dos fases. La primera ocurre una sola vez: se da de alta una fuente de información que extenderá el conocimiento disponible para el LLM más allá de su corpus de entrenamiento. Un RAG puede tener múltiples fuentes y en múltiples formatos; en este caso, simplificado al extremo, se usa una sola fuente de información y en el formato más simple que existe: un documento de texto (corpus). Para un documento de texto, este se corta en pasajes (troceado), cada pasaje se convierte en un vector (vectorización) y los vectores se guardan en una base de datos especializada en vectores (almacén de vectores; sobre cómo se representa un texto como vector y cómo se busca entre millones de ellos de forma eficiente, véanse [2] y [13]). La segunda ocurre en cada pregunta: la pregunta se transforma en un vector del mismo tipo y se buscan en la base de datos los vectores más cercanos a él (recuperación). Cada vector encontrado tiene guardado el pasaje de texto del que salió, y son esos pasajes los que se recuperan y se entregan al modelo junto con la pregunta (prompt aumentado) para que redacte la respuesta (generación).
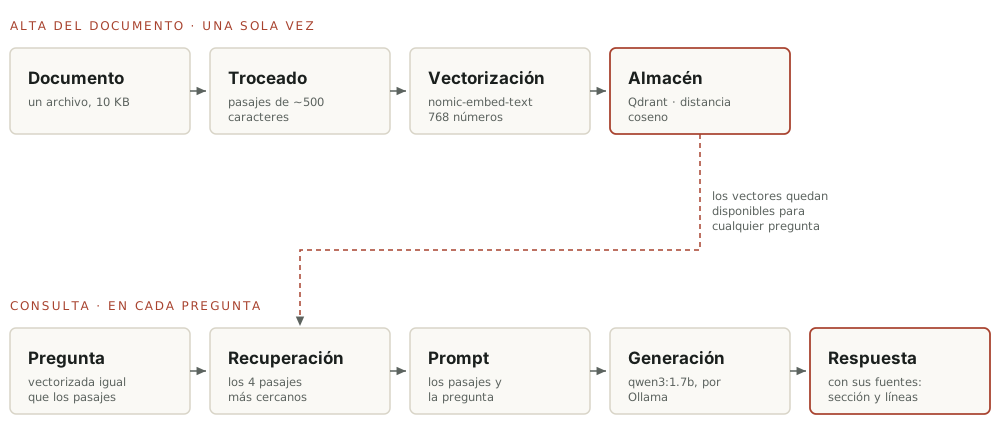
Seis componentes, cada uno con una sola responsabilidad:
| Componente | Qué hace | Qué lo ejecuta |
|---|---|---|
| Corpus | El documento del que salen las respuestas | Un archivo de texto en formato Markdown [14] |
| Troceado | Corta el documento en pasajes, en sus encabezados | Código TypeScript [15] |
| Vectorización | Convierte un texto en un vector | Ollama, nomic-embed-text |
| Almacén de vectores | Guarda los vectores y encuentra los más cercanos a una pregunta | Qdrant, en Docker |
| Recuperación y prompt | Vectoriza la pregunta, trae los pasajes y arma el prompt | Código TypeScript [15] |
| Generación | Escribe la respuesta a partir de los pasajes, palabra por palabra | Ollama, qwen3:1.7b |
Ninguno de los seis componentes necesita internet después de instalarse. Los dos modelos corren con Ollama, que los expone en una interfaz de programación local [7]; los vectores viven en Qdrant, una base de datos vectorial que se levanta con un comando de Docker [6]. El montaje completo ocupa 1.7 GB de modelos descargados y no cuesta nada por consulta.
Los componentes, uno por uno
El troceado corta el documento en pasajes de unos 500 caracteres, respetando los encabezados y sin partir una tabla a la mitad. El criterio es que un vector debería significar una sola cosa: un pasaje que mezcla tres temas produce un vector que no se parece del todo a ninguno de los tres, y entonces no lo encuentra ninguna pregunta. Como el corte sigue la estructura del documento, cada pasaje conserva su sección y sus líneas, y por eso una respuesta puede decir de dónde salió.
La vectorización convierte cada pasaje en 768 números [a] con nomic-embed-text [4]. Dos textos que hablan de lo mismo crearán un vector similar, y esa es toda la diferencia con buscar por coincidencia literal: la pregunta “¿cómo se parte un documento?” encuentra el pasaje sobre troceado sin que la palabra “troceado” aparezca en ella.
El almacén de vectores es Qdrant, con distancia coseno [6]. Tiene guardados los vectores de todos los pasajes del documento, junto con el texto de cada pasaje. Cuando recibe el vector de la pregunta, busca entre los vectores guardados los más parecidos a ese vector y devuelve los pasajes que les corresponden.
La recuperación vectoriza la pregunta igual que los pasajes y pide los cuatro más cercanos. Cuatro, y no veinte, porque el prompt tiene que seguir cabiendo en una ventana de contexto que aquí se dejó pequeña a propósito: en una CPU lenta, procesar el prompt es la parte cara.
El prompt aumentado es texto plano: los cuatro pasajes, la pregunta y la instrucción de responder solo con lo que está en los pasajes. Se decidió mostrarlo tal como se arma, con fines didácticos.
La generación la hace qwen3:1.7b [5], con el modo de razonamiento apagado y temperatura en cero. Es un modelo pequeño elegido por una razón práctica: es el más rápido de los que probé que todavía llama bien a las herramientas. La respuesta llega palabra por palabra, así que la página muestra algo al instante en lugar de quedarse en blanco quince segundos.
El documento que se explica a sí mismo
El corpus es un solo archivo de unos 10 KB: el artículo de Wikipedia en inglés sobre RAG, en una revisión fija y bajo licencia Creative Commons Atribución-CompartirIgual [3].
Al responder sobre RAG leyendo el artículo sobre RAG, el sistema se vuelve verificable por su propio lector: cualquiera puede abrir el texto, buscar la sección que la respuesta cita y comprobar si dice lo que el modelo afirma. Es la misma regla con la que escribo en este blog —ninguna afirmación sin su fuente, y la fuente a la vista— aplicada a una máquina.
Las mediciones
Medido el 25 de octubre de 2026 en un Intel Core i7-6600U de dos núcleos, sin tarjeta gráfica, con los modelos ya cargados. Las transcripciones completas están en el repositorio [10].
| Qué | Resultado |
|---|---|
| Alta del documento | 25 pasajes, vectorizados y guardados en 9 segundos |
| Recuperación, diez preguntas | El pasaje correcto está entre los cuatro devueltos en 10 de 10; es el primero en 6 de 10 |
| Tamaño de pasaje | 500 caracteres, elegido sobre 800, 1200 y 1500 midiendo las mismas diez preguntas |
| Modo LLM | Primera palabra en 0.6 s; respuesta terminada en 4.2 s |
| Modo RAG | Las fuentes aparecen en 0.4 s; la misma pregunta, en 16.3 s |
| Modo agente | 18.7 s y 46.3 s en dos preguntas |
| Comprobaciones | 86 pruebas en verde, más la verificación de tipos |
El alta del documento tomó 9 segundos para 25 pasajes. En la consulta, la recuperación tomó 0.4 segundos y la respuesta terminó en 16.3; la misma pregunta en modo LLM, sin recuperación, terminó en 4.2. El pasaje correcto apareció entre los cuatro devueltos en las diez preguntas, y en primer lugar en seis de ellas.
Sobre el alcance. Para efectos de entender cómo funciona un RAG, estos tiempos de respuesta son aceptables y el montaje cumple su objetivo. Un corpus más grande aumentaría el tiempo del alta y el de la recuperación, algo que aquí no se midió. Esta es una prueba de concepto con fines didácticos y no busca comportarse como un producto de grado empresarial: prueba el concepto técnico de un RAG de la manera más simple y a costo cero.
Tres formas de preguntar
En este modelo la misma pregunta se puede hacer de tres maneras, y esa comparación es lo que hace didáctico al montaje.
En modo LLM la pregunta va sola al modelo. Se ve lo que sabe de memoria: rápido y sin fuentes.
En modo RAG se recuperan primero los cuatro pasajes más cercanos a la pregunta; con esos cuatro y la pregunta se arma el prompt, y el modelo responde a partir de él. Debajo de la respuesta aparece la lista de fuentes, cada una con su sección y sus líneas.
En modo agente el modelo además decide. Puede buscar más pasajes si los que tiene no le alcanzan, o señalar una etapa del diagrama que la página dibuja al lado del chat. Es la diferencia entre un flujo fijo y uno donde el modelo elige el siguiente paso.
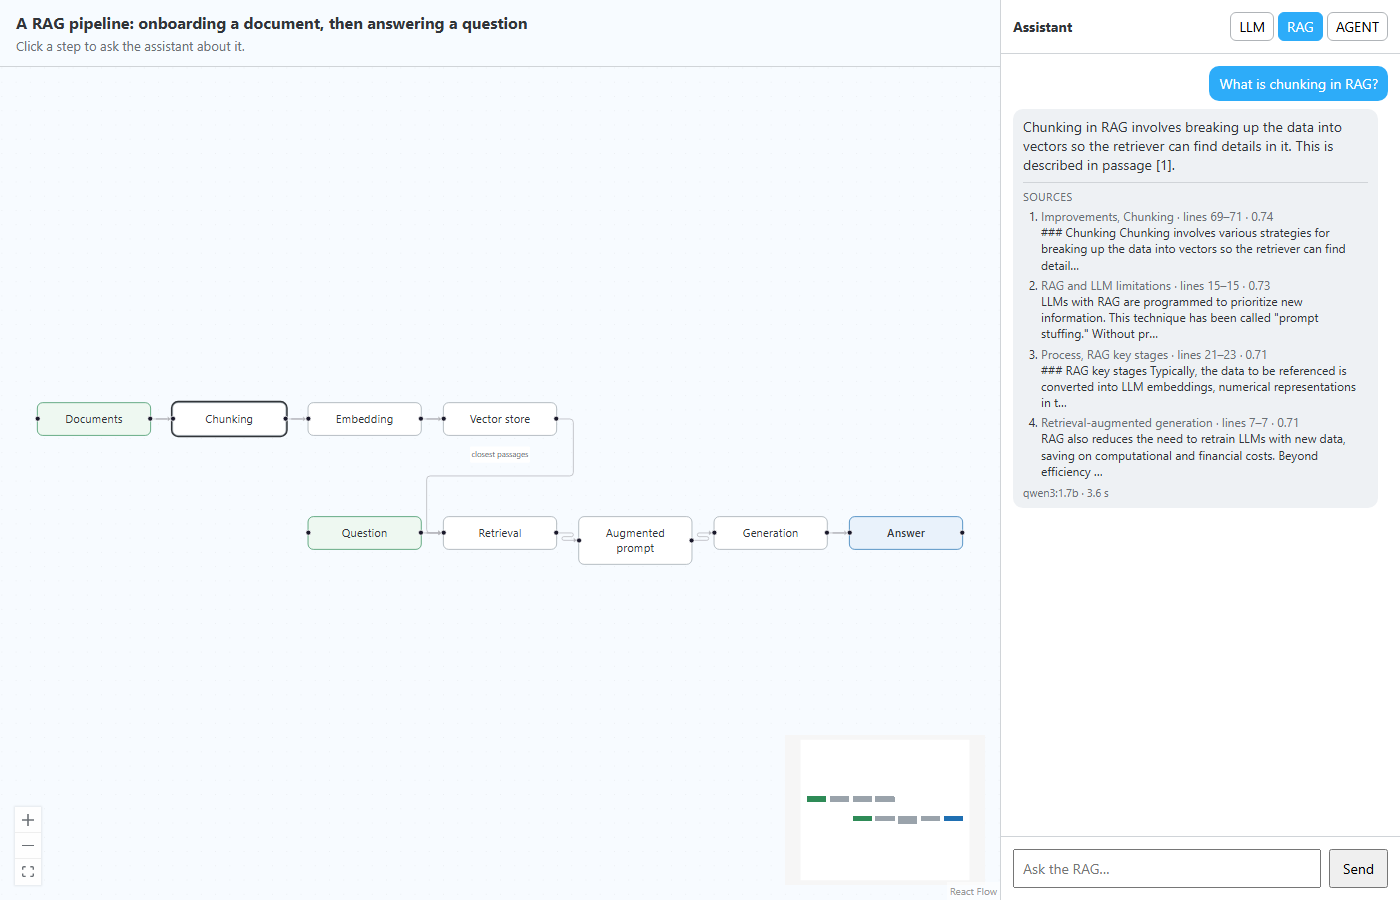
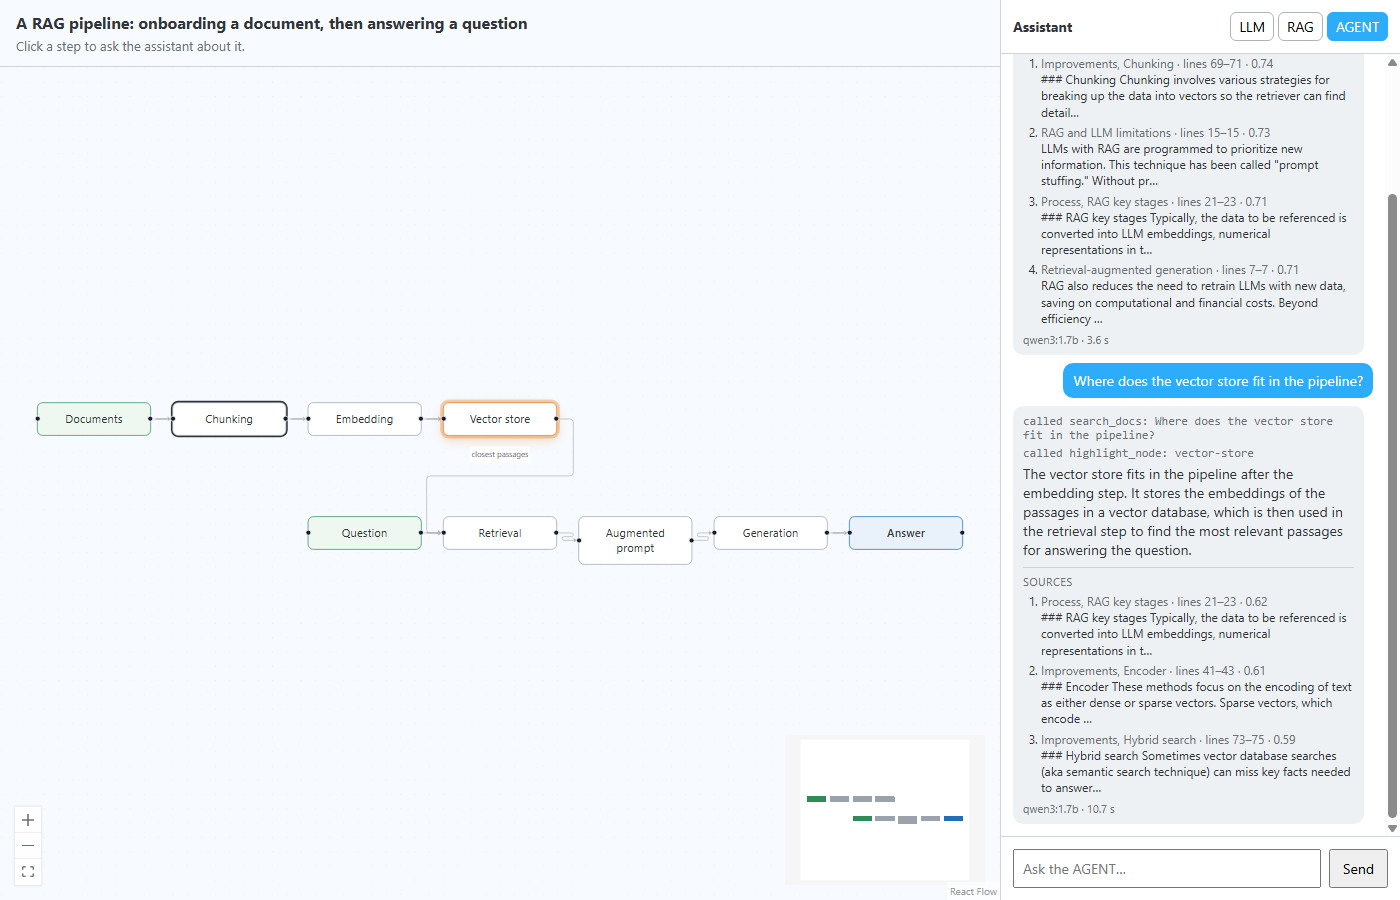
Lo que este montaje no resuelve
Lee un solo archivo y no interpreta PDF. No tiene búsqueda por palabra clave junto a la vectorial, ni reordenamiento de resultados, ni un conjunto de evaluación con respuestas esperadas: las diez preguntas se revisaron a mano. No tiene autenticación y asume un solo usuario.
El modelo, por su parte, se equivoca. A veces cita un pasaje por su número en lugar de por su sección, y a veces rellena. La lista de fuentes bajo cada respuesta es lo que hay que creerle; el texto es lo que hay que verificar.
Nada de esto es un defecto del montaje: es su alcance.
Cómo correrlo
Hacen falta Node.js 24, Docker y Ollama. Se descargan los dos modelos, se levanta Qdrant con un comando, se corre la ingesta y se abre la página. Está probado en Windows 11 y una vez en Ubuntu dentro de un contenedor de desarrollo; en macOS no lo he verificado.
Para no instalar nada, el repositorio trae un botón que levanta todo en GitHub Codespaces, en una máquina en la nube que se construye sola [10]. Hace falta una cuenta de GitHub registrada: el plan gratuito para cuentas personales incluye 15 GB-mes de almacenamiento y 120 horas de cómputo al mes [16]. En la máquina gratuita de dos núcleos la página abrió y el chat respondió en 26.2 segundos la primera vez, mientras el modelo se cargaba, y en 12.2 la segunda.
Lo que sigue
La aplicación que me interesa de verdad no es un RAG sobre Wikipedia. Es uno sobre el Anexo 20, el Código Fiscal de la Federación y la Resolución Miscelánea Fiscal: documentos largos, versionados y llenos de catálogos, donde una respuesta que suena bien pero no puede señalar la regla exacta de la que salió no sirve de nada. Ese problema tiene todo lo que este montaje deja fuera —muchos documentos, versiones que conviven, terminología que hay que respetar al pie de la letra— y es el siguiente experimento de esta línea.
Notas
[a] 768 números por pasaje es la dimensión de salida de nomic-embed-text [4]. El número en sí no tiene lectura intuitiva: no hay una coordenada que signifique “habla de bases de datos”. Lo que importa es la geometría del conjunto, es decir, qué tan cerca cae un texto de otro, y eso es lo que mide la distancia coseno [6].
[b] Gran modelo de lenguaje es el equivalente que FundéuRAE recomienda para large language model, junto con modelo extenso de lenguaje; el primero está recogido en IATE, la base terminológica multilingüe de la Unión Europea [11]. La sigla es invariable en plural: los LLM, no los LLMs.
Referencias
[1] Lewis, P., Perez, E., Piktus, A. et al. (2020). "Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks". Advances in Neural Information Processing Systems 33. El trabajo que define la técnica y acuña el nombre. https://arxiv.org/abs/2005.11401
[2] Karpukhin, V., Oğuz, B., Min, S. et al. (2020). "Dense Passage Retrieval for Open-Domain Question Answering". EMNLP 2020. La recuperación por vectores densos sobre la que se apoya el RAG. https://arxiv.org/abs/2004.04906
[3] Wikipedia, "Retrieval-augmented generation", revisión 1381095247 (20/10/2026), bajo licencia Creative Commons Atribución-CompartirIgual 4.0. Es el corpus que responde este montaje; autoría, revisión y cambios se detallan en data/NOTICE.md del repositorio. https://en.wikipedia.org/w/index.php?title=Retrieval-augmented_generation&oldid=1381095247 https://creativecommons.org/licenses/by-sa/4.0/
[4] Nussbaum, Z., Morris, J. X., Duderstadt, B. & Mulyar, A. (2024). "Nomic Embed: Training a Reproducible Long Context Text Embedder". El modelo de embedding usado para vectorizar pasajes y preguntas. https://arxiv.org/abs/2402.01613 https://ollama.com/library/nomic-embed-text
[5] Qwen Team (2025). "Qwen3 Technical Report". La familia del modelo generador qwen3:1.7b, incluido su modo de razonamiento conmutable. https://arxiv.org/abs/2505.09388 https://ollama.com/library/qwen3
[6] Qdrant, documentación oficial: búsqueda por similitud, métricas de distancia y colecciones. https://qdrant.tech/documentation/concepts/search/
[7] Ollama, documentación de su API REST: generación de respuestas, embeddings y transmisión por flujo. https://github.com/ollama/ollama/blob/main/docs/api.md
[8] Remix, framework web reconstruido sobre estándares de la plataforma. La versión 3.1.0, en beta al momento de este montaje, es la que hospeda la página. https://remix.run
[9] React Flow (xyflow), biblioteca de diagramas de nodos con la que se dibuja el canvas del pipeline. https://reactflow.dev
[10] Díaz Macedo, M. (2026). remix3-local-rag-agent: código, documento de arquitectura, mediciones y transcripciones. Licencia MIT. https://github.com/migueldiaz66/remix3-local-rag-agent
[11] FundéuRAE (22 de septiembre de 2025). «los LLM», mejor que «los LLMs». Equivalentes en español de large language model e invariabilidad de la sigla en plural. https://www.fundeu.es/recomendacion/los-llm-mejor-que-los-llms/
[12] Wikipedia, «Generación aumentada por recuperación». Definición general de la técnica, sus variantes y su literatura, en español. https://es.wikipedia.org/wiki/Generaci%C3%B3n_aumentada_por_recuperaci%C3%B3n
[13] Malkov, Yu. A. & Yashunin, D. A. (2020). "Efficient and robust approximate nearest neighbor search using Hierarchical Navigable Small World graphs". IEEE Transactions on Pattern Analysis and Machine Intelligence 42(4). El algoritmo HNSW, con el que los almacenes vectoriales resuelven la búsqueda por cercanía; es el que indexa los vectores en Qdrant. https://arxiv.org/abs/1603.09320 https://qdrant.tech/documentation/concepts/indexing/
[14] Wikipedia, «Markdown». El lenguaje de marcado ligero en el que está escrito el archivo que sirve de corpus. https://es.wikipedia.org/wiki/Markdown
[15] TypeScript, sitio y documentación oficiales del lenguaje: JavaScript con tipos verificados antes de ejecutar. Es el lenguaje en el que está escrito el montaje. https://www.typescriptlang.org/ https://es.wikipedia.org/wiki/TypeScript
[16] GitHub, documentación de facturación de GitHub Codespaces: las cuotas mensuales incluidas en cada plan de cuenta, entre ellas la del plan gratuito para cuentas personales. https://docs.github.com/en/billing/concepts/product-billing/github-codespaces
Glosario
- Agente (de modelo de lenguaje)
- Montaje en el que el modelo no solo responde sino que decide qué hacer: buscar más información, ejecutar una herramienta o actuar sobre la interfaz. Más flexible que un flujo fijo y menos predecible.
- Alucinación
- Respuesta inventada que un modelo presenta con la misma seguridad que una correcta. La generación aumentada por recuperación no la elimina: la reduce y, al exigir que cada respuesta cite sus pasajes, la vuelve detectable.
- Base de datos vectorial
- Base de datos especializada en guardar vectores y encontrar los más cercanos a uno dado. Usa índices para no comparar la consulta contra todos los vectores guardados.
- Cobertura en los primeros k (recall@k)
- Proporción de preguntas en las que el pasaje correcto aparece entre los k primeros resultados de la búsqueda. Es la medida básica para decidir si la recuperación sirve, separada de la calidad de la redacción final.
- Corpus (en generación aumentada por recuperación)
- Conjunto de documentos del que un sistema de recuperación saca sus respuestas. No es el corpus de entrenamiento del modelo: este se da de alta después, se puede cambiar o ampliar, y delimita exactamente lo que el sistema está en condiciones de contestar.
- Embedding (vector semántico)
- Lista de números que representa el significado de un texto, de modo que dos textos sobre el mismo asunto quedan cerca en ese espacio aunque no compartan palabras. Es lo que permite buscar por sentido y no por coincidencia literal.
- Llamada a herramientas (tool calling)
- Capacidad de un modelo para pedir la ejecución de una función declarada, con sus argumentos, en lugar de contestar con texto. Los modelos pequeños la manejan bien solo cuando las opciones son pocas.
- LLM Gran modelo de lenguaje
- Modelo entrenado sobre grandes volúmenes de texto para predecir la continuación de una secuencia. Solo conoce lo que vio durante su entrenamiento, y esa limitación es la que la generación aumentada por recuperación viene a cubrir.
- Modo de razonamiento
- Comportamiento de ciertos modelos que, antes de contestar, generan una cadena de pasos intermedios. Ayuda en tareas que exigen deducción y multiplica el tiempo de respuesta; aquí está apagado porque la tarea es redactar a partir de pasajes ya recuperados.
- Ollama
- Programa que descarga y ejecuta modelos de lenguaje en la propia máquina y los expone en una interfaz de programación local. Permite montar un sistema completo sin servicio en la nube ni llave de acceso.
- Pasaje
- Cada uno de los fragmentos en que se corta un documento. Es la unidad que se vectoriza, se almacena, se recupera y se cita como fuente de una respuesta.
- Prompt aumentado
- Texto que finalmente recibe el modelo: los pasajes recuperados, la pregunta y la instrucción de responder solo con lo que está en ellos. Es donde la recuperación se vuelve contexto.
- Qdrant
- Base de datos vectorial de código abierto, con búsqueda por similitud y filtros, que se levanta en un contenedor. Es el almacén de vectores de este montaje.
- RAG Generación aumentada por recuperación
- Técnica que, antes de que un modelo de lenguaje responda, busca en un conjunto de documentos los fragmentos pertinentes y se los entrega junto con la pregunta. El modelo deja de responder de memoria y responde a partir de un texto que se puede verificar.
- Recuperación (retrieval)
- Paso que convierte la pregunta en un vector y trae del almacén los pasajes más cercanos. Es la "R" de RAG y, medido, suele ser la parte barata del proceso.
- Similitud coseno
- Medida de parecido entre dos vectores por el ángulo que forman, con independencia de su magnitud. Es la métrica habitual para decidir qué pasaje se acerca más a una pregunta.
- Temperatura
- Parámetro que gradúa cuánto azar introduce el modelo al elegir cada palabra. En cero toma siempre la opción más probable, de modo que la misma pregunta sobre los mismos pasajes devuelve la misma respuesta y el resultado se puede repetir.
- Troceado (chunking)
- Corte de un documento en fragmentos manejables antes de vectorizarlos. El tamaño y el punto de corte deciden la calidad de la recuperación: un fragmento que mezcla varios temas produce un vector que no se parece del todo a ninguno.
- Vectorización de la pregunta
- Conversión de la pregunta en un vector con el mismo modelo que vectorizó los pasajes. Solo así ambos quedan en el mismo espacio y la distancia entre ellos significa algo: con modelos distintos, la búsqueda por cercanía no mide nada.
- Ventana de contexto
- Cantidad máxima de texto que un modelo puede tener presente de una vez, contando el prompt y la respuesta. Limita cuántos pasajes se le pueden entregar y encarece el procesamiento cuando crece.
Preguntas frecuentes
¿Qué es RAG?
La generación aumentada por recuperación (RAG, retrieval-augmented generation) es una técnica que le da a un modelo de lenguaje un documento que leer antes de responder. El documento se corta en pasajes, cada pasaje se guarda como un vector, la pregunta se convierte en un vector del mismo tipo, se buscan los pasajes más cercanos y se le entregan al modelo junto con la pregunta. La propusieron Lewis y colaboradores en 2020.
¿Para qué sirve RAG si el modelo ya sabe mucho?
Porque solo sabe lo que vio al entrenarse. No conoce tus documentos internos, ni lo publicado después de su corte, ni tu caso particular, y cuando no sabe suele inventar en lugar de callarse. RAG acota la respuesta a un texto que tú eliges y permite verificarla contra el pasaje del que salió.
¿Hace falta una tarjeta gráfica para correr un RAG?
No para una prueba de concepto. Este montaje se midió en una laptop de 2016 con dos núcleos y sin GPU: la ingesta del documento tomó 9 segundos y una respuesta con recuperación, 16.3 segundos. Con tarjeta gráfica es más rápido, pero no es un requisito para entender ni para demostrar la técnica.
¿Hace falta una llave de API o una cuenta en la nube?
No. Los dos modelos corren localmente con Ollama y la base de datos de vectores es Qdrant en un contenedor de Docker. No sale una sola petición a internet durante la operación, no hay costo por consulta y los documentos no salen de la máquina.
¿Qué es un embedding?
Es la conversión de un texto en una lista de números —en este montaje, 768— que representa su significado, de forma que dos textos que hablan de lo mismo quedan cerca en ese espacio aunque no compartan ni una palabra. Esa cercanía es la que permite encontrar el pasaje pertinente sin buscar por coincidencia literal.
¿De qué tamaño conviene cortar los pasajes?
Depende del documento y hay que medirlo, no adivinarlo. Aquí se probaron cortes de 500, 800, 1200 y 1500 caracteres contra el mismo conjunto de diez preguntas y ganó el de 500. El criterio de fondo es que un vector debería significar una sola cosa: un pasaje que mezcla tres temas produce un vector que no se parece del todo a ninguno.
¿RAG elimina las alucinaciones?
No. Las reduce y, sobre todo, las hace detectables, porque cada respuesta viene con los pasajes de los que salió y se puede comprobar. El modelo sigue pudiendo inventar: en este montaje, uno de 1700 millones de parámetros a veces cita un pasaje por su número en lugar de por su sección. La lista de fuentes es lo que hay que creerle.
¿En qué se diferencia un RAG de un agente?
En un RAG la recuperación siempre ocurre, de la misma forma y antes de responder. En el modo agente el modelo decide: puede buscar más pasajes si los que tiene no le bastan, o ejecutar otra acción. Es más flexible y también menos predecible, y un modelo pequeño se pierde si se le dan demasiadas opciones.
¿Puedo usar mis propios documentos?
Sí: basta apuntar la variable CORPUS_PATH a otro archivo y volver a correr la ingesta. El montaje lee un solo archivo Markdown a propósito, para no mezclar el mecanismo con el trabajo de interpretar PDF, hojas de cálculo o correo. Cada documento nuevo llega además con su propia licencia.
¿Sirve esto para documentos fiscales como el Anexo 20?
Es la aplicación natural y el siguiente paso de esta línea. Las reglas fiscales son documentos largos, versionados y llenos de catálogos, donde lo que importa no es que la respuesta suene bien sino que pueda señalar la regla exacta de la que salió. Un montaje como este, donde cada respuesta trae su pasaje, es el punto de partida correcto para esa clase de problema.